协脑.企业Wiki // 产品介绍
协脑.企业Wiki · 宣传手册

让组织的知识,
会生长。

把散落的文档,编译成一座持续生长的知识 Wiki。

「一家公司最值钱的资产,不在账上——在老员工的脑子里,在散落的文件夹里,在离职交接的那两周里。我们把它留下来。」
把文档编译成知识·让问答站在积累之上·2026-08
协脑.企业Wiki 封面氛围图
COVER / 2026-08

知识,是公司的重要资产

四个场景,请在心里打个分:我们公司有没有、有多疼。

立论 · 知识的重量

公司要做强、要规范,靠的不只是钱和人——靠的是经验的积累、知识的积累。项目怎么做过、制度怎么定、订单怎么谈、设备怎么修,这些知识,是公司最容易被忽视、也最容易被遗忘的资产。

被遗忘的知识 · FIVE KINDS
项目信息项目一结束,就封进档案盒。
管理制度真正问的人,翻不到那一页。
订单信息报价底线,都在个人脑子里。
维修经验只有修过它的老师傅知道。
灵光一现两小时后,连自己也找不回。
四幕场景 · 你一定不陌生
场景一插画:人一走,经验清零

场景一人一走,经验清零

交接写了三页,真正值钱的一页没留下。

经验没有清零,只是跟着他走了。
场景二插画:新人三个月才能独立干活

场景二新人三个月才能独立干活

流程、模板、上次怎么处理,全靠新人自己拼。

拼图的这段时间,公司付的是全薪。
场景三插画:员工没处问

场景三员工没处问

答案写在制度里,制度却躺在 OA 第三层目录。

不问的代价,比答错更大。
场景四插画:没处可问,涌向高手

场景四没处可问,涌向高手

最贵的员工,每天两小时回答「文件在哪」。

把判断压在一个人身上,是最贵的架构。
四种介质 文字语音照片视频

这些成本从来不出现在报表里。但它每天都在发生。

传统方式每次都从零开始;协脑让每一次提问,都站在全部积累之上。

从「每次从零」,到「知识复利」

今天,为什么失效

  • 文档进了网盘,就等于进了坟墓——搜索能找到文件,找不到答案。
  • 通用 AI 问答每次从头推理——问完即焚,组织没有因此变得更聪明。
  • 传统知识库越攒越慢、越攒越搜不到——积累反而成了负担。
VS

协脑的方式

  • 每加入一份文档,系统把它编译成知识:摘要、概念、实体、交叉引用,一次织好,永久留存。
  • 之后的每一次提问,都站在全部积累之上。
  • 文档越积越多,答案越问越准——这就是知识复利。

传统检索,每次都从零开始;协脑的 Wiki,让知识复利。

开工前先答两个问题——为什么是 Wiki,不是知识库?为什么是我们,不是别人?

知识库装文件,我们织知识;搜索找文件,我们给答案。

观点一 · 吞得下任何格式的知识,关键是建立关联

为什么选 Wiki,不选知识库

WordPDFExcel图片语音视频网页扫描件

存得下不是重点:每份文档入库即被编译成摘要、概念、实体、交叉引用;同一件事在合同、周报、微信群里的不同表述,自动织在一起。

知识库 = 文件仓库。搜索能找到文件,找不到答案。
观点二 · 不单单是搜索,是自主推理

为什么是我们,不是别人

结构定位跨文档综合强制回源逐段出处

每一次问答,都站在全部积累之上推理;通用 AI 问完即焚,组织没有因此变得更聪明。

我们直接给答案,每一句都能点开核对——不是搜到文件自己拼。

知识库装文件,我们织知识;搜索找文件,我们给答案。

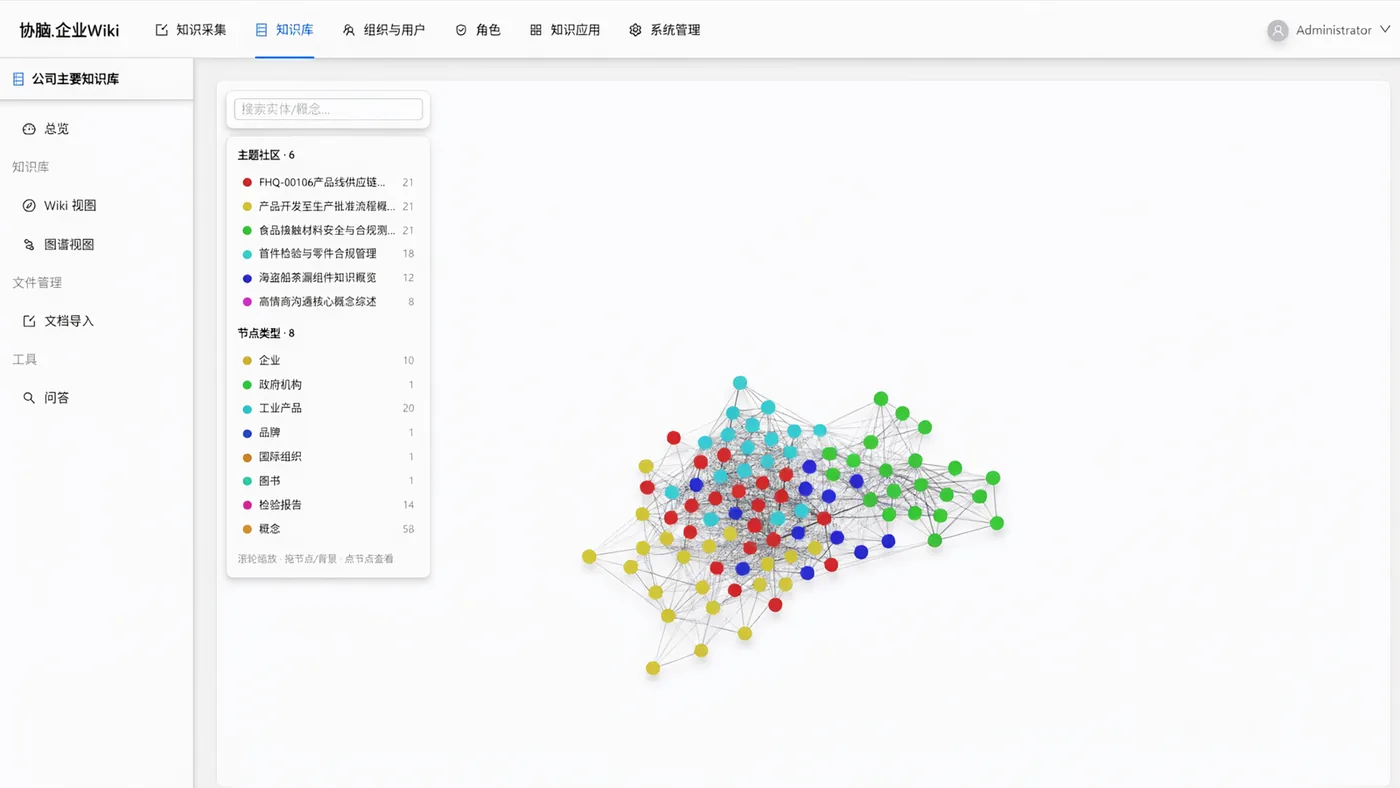
你看到的不是一堆文件,而是一张结构化的知识网。

能力一 · 知识 Wiki

01
知识生长
人走,经验不走
02
交叉引用
同一主题自动织在一起
03
长文档树索引
百页长文,一问到点
04
透明可审计
知识长什么样,一眼可见
05
可信溯源
每个结论都能点开看出处
06
海量文档
一百万页,同一条目录路径
07
精确度
找到「对的」,不是「像的」
08
复杂 Excel
整张表格固化为可查知识
09
千页扫描 PDF
纸面档案变成可问知识
10
文档级权限
每个人只看见该看的

文字、图片、视频、语音,皆可入库编译。

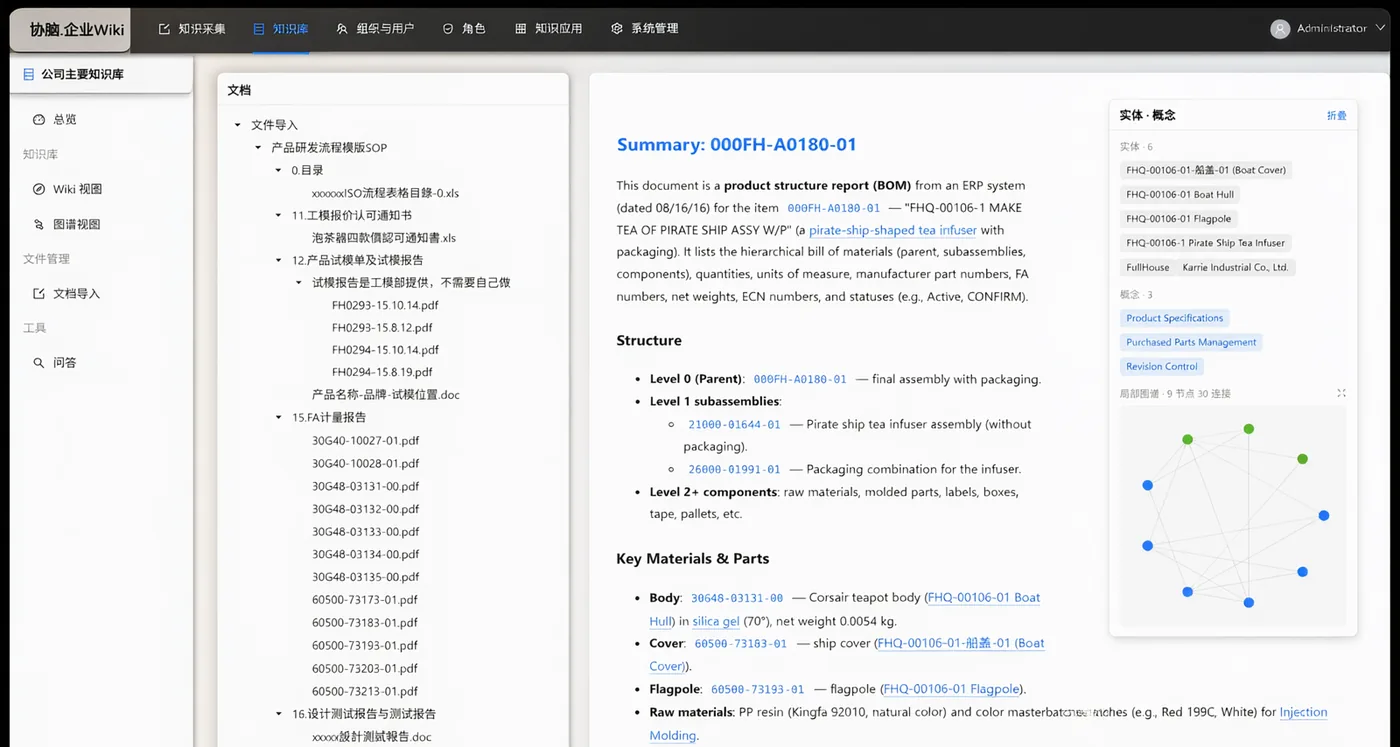
知识网络视图 · 产品实拍
知识网络视图 · 产品实拍

每份文档入库,即自动维护摘要页、概念页、实体页、索引与日志。

一篇文档,可能点亮十几页知识。

知识生长 × 交叉引用

优势一知识生长

每份文档入库即被编译成持久的 Wiki——摘要、概念、实体、索引与日志自动维护。一篇文档,可能点亮十几页知识。

优势二交叉引用

不同文档对同一件事的论述,被汇聚、比对、互链;人、组织、地点、产品自动归集。矛盾之处,主动现形。
文档入库
→
编译流水线
→
知识 Wiki
摘要概念实体索引日志
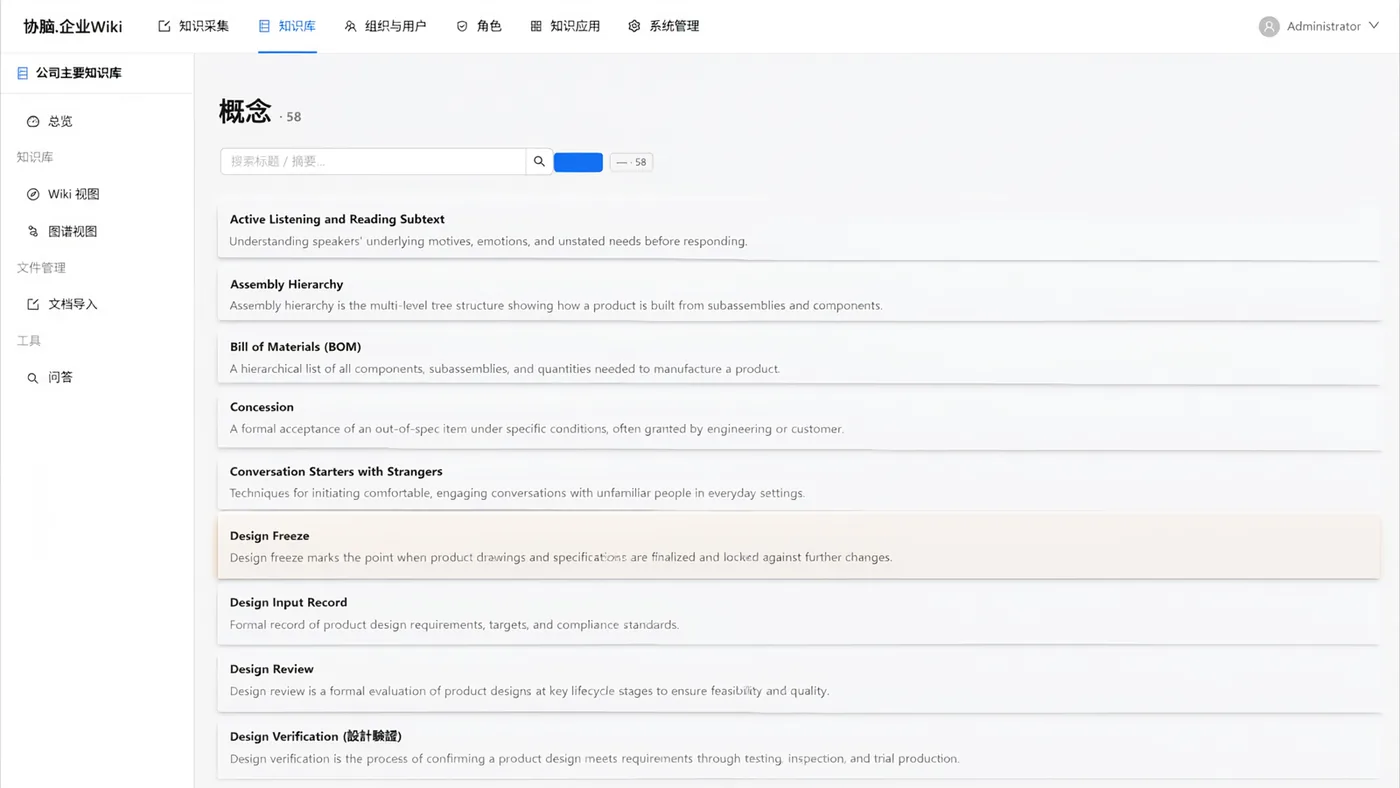
概念页 · 产品实拍
概念页 · 产品实拍
知识图谱 · 产品实拍
知识图谱 · 产品实拍
场景 · 跨部门拼图:承诺在微信群、条款在法务 PDF、交付在项目周报;搜客户名字,三处内容带着出处同时浮现。

知识自己找到了彼此。

长文档树索引 × 透明可审计

优势三长文档树索引

沿文档自身的结构推理定位,不切碎、不丢上下文。公司积累越多,系统越从容——而不是越用越慢。

优势四透明可审计

Wiki 不是数据库里的黑盒,而是目录里井然有序的 Markdown 文件:可直接浏览、可画出知识图谱、可纳入版本管理逐行审计。你的知识资产,永远属于你自己。

300 页制度汇编 · 章节树
第 1 章
第 2 章
第 3 章
└ 3.2 报销口径
第 4 章
wiki/ · 目录里井然有序的 Markdown
wiki/
├─ concepts/客户成功.md
├─ entities/华东区.md
├─ sources/制度汇编.pdf.md
└─ index/知识图谱.graph
Wiki 目录:井然有序的 Markdown · 产品实拍
Wiki 目录 · 井然有序的 Markdown · 产品实拍
版本管理wiki/ 就是普通文件目录,可直接纳入 git——每一次修改都有提交记录
逐行审计Markdown 纯文本,diff 精确到每一行,谁改了什么一目了然
差异可追踪任意两个版本对比有凭有据,每处改动都能回溯来龙去脉
可完整带走标准开放格式,随时整体导出迁移,不被任何平台绑定
知识资产永远属于你自己。

透明,才敢把核心知识放进去。

每个结论,都能点开看出处。

优势五 · 可信溯源

答案不是即兴发挥,而是从编译好的知识里生长出来——每段标注来源,一键点开,回看原文。

信任是长出来的,不是要求出来的。
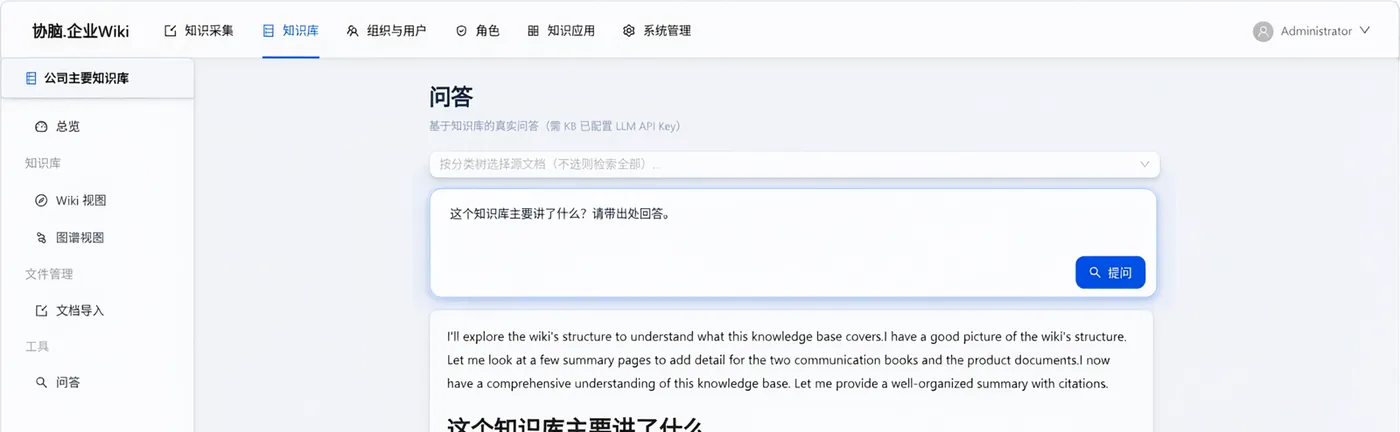
回源闸门:每一个结论,都被强制回到原文核对。溯源不是附加功能,是默认姿势。(详见三顾虑页)
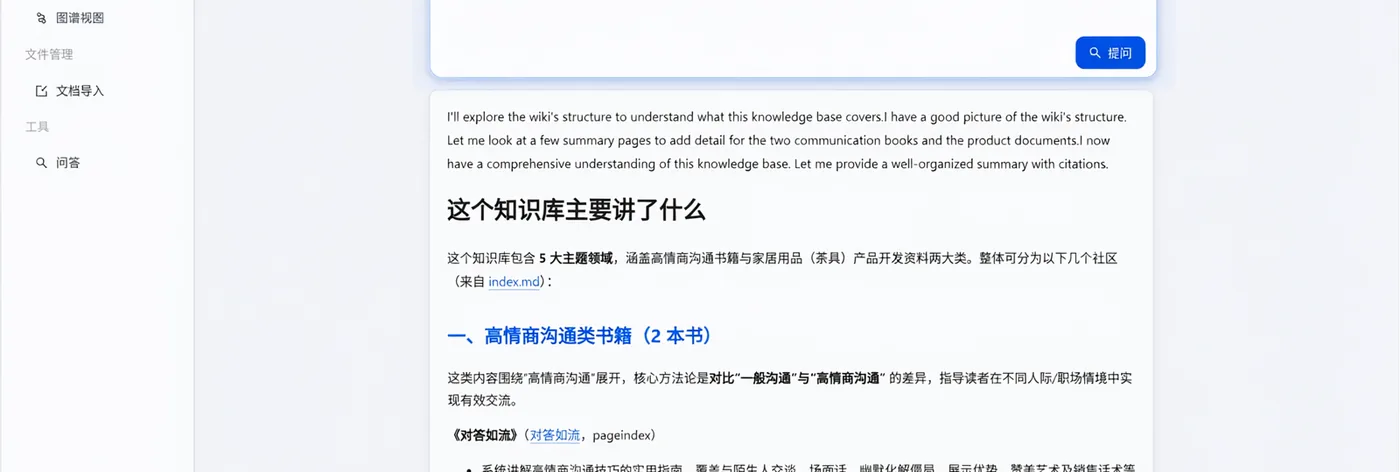
问答页 · 产品实拍
问答页 · 产品实拍
答案引用出处标注 · 产品实拍
答案引用出处标注 · 产品实拍
华东区客户的报价底线,上一次是怎么定的?
上次报价底线由三项条件共同决定:客户年框承诺、交付排期,以及 2025 年 Q4 毛利率红线。最终成交口径为 82 折,另附两项服务条款。该结论来自三份材料,可逐段回看原文。
[1] 项目复盘[2] 报价审批[3] 客户周报
引用出处 · SOURCE TRACE
012025Q4_华东项目复盘.md第 4 节 · 定价决策
02报价审批流_2025-11.pdf第 2 页 · 审批条件
03客户周报_第 48 期.md服务条款变更记录

RAG 召回「像的」,协脑找到「对的」。

优势六 × 七 · 海量文档 × 精确度——越大越从容,每条都敢核对

规模 · SCALE

传统 RAG 知识库

  • 文档切碎塞进向量库,库越大噪声越大。
  • 相似度排序 Top-K 截断,长尾文档永远浮不上来。
  • 规模是它的天花板:加得越多,答得越飘。

协脑.企业Wiki

  • 不切碎,沿文档结构建树索引,上下文完整。
  • 结构推理而非相似度海选,一百万页也走同一条目录路径。
  • 规模是它的护城河:文档越积越多,系统越从容。

库越大,差距越大。

精确度 · PRECISION

传统 RAG 知识库

  • 相似度 ≠ 正确,召回的是「看着像的」。
  • 片段切碎、上下文断裂,张冠李戴。
  • 没有强制回源,模型自由发挥,编得理直气壮。

协脑.企业Wiki

  • 结构定位、上下文完整,回答的是「那一节」不是「那几个词」。
  • 每个结论强制回源核对,逐段标注引用出处。
  • 答案可逐条点开验证,精确度可审计。

RAG 赌模型不编,协脑让答案没机会编。

最复杂的两种文档,也吃得下。

优势八 × 九 · 再复杂的文档,也能固化成 Wiki

优势八 · 复杂 Excel 表格

  • 多表头|合并单元格|跨表公式,结构化原样解析。
  • 表格语义进 Wiki:字段、口径、计算逻辑,成为可查的知识。
  • 问「上季度华东区毛利率」,答的是那张表的那一格——带出处。

优势九 · 千页扫描 PDF

  • 逐页识别还原,沿文档自身结构建树索引——1000 页也一问到点。
  • 历史档案、合同汇编、标书合集,连同版式一起进库。
  • 沉睡的纸面资产,变成可问的知识。

不管多长、多复杂、多「非文本」——入库,即成知识。

薪酬、人事、合同——进了知识库,也不会全员可见。

优势十 · 文档级权限:同一张网,每个人只看见该看的

授权粒度 · RBAC

  • 按单份文档授权、按分类子树整棵授权、按导入来源授权;支持反向剔除,先给整棵树,再单独摘掉敏感文件。
  • 默认全拒:没有任何授权,一份也看不见。

个人私有文档

  • 员工个人导入的资料,仅本人可见;产品体系内,连超级管理员也看不到。
  • 隐私优先于权限体系。

贯穿到答案与 Wiki

  • 问答时越权文档不参与回答,被问到就明说「无权访问」,而不是偷偷用它答。
  • 概念页按段落标注来源——不同权限的人打开同一页,各自只看见有权的那几段,零泄露。
权限树 · 反向剔除,默认全拒
企业知识库 / 全部文档
├─ 制度与流程
├─ 项目交付
├─ 薪酬与人事(未授权不可见)
└─ 合同与报价(未授权不可见)
反向剔除默认全拒
上季度薪酬调整口径?
你无权访问该文档。——越权资料不会进入回答。
公开段落部门段落敏感段落

部门的墙还在,权限还隔离着——但知识在同一张网上生长。

像与一位读过全部文档的老员工交谈。

能力二 · 智能问答

基于 Wiki 的问答

答案从编译好的知识里生长出来;每段标注来源,一键回看原文。

多轮对话

带着上下文追问,越问越深——先问全貌,再追细节,再比较差异。

答案回流

满意的答案一键存回 Wiki,成为知识的一部分——连问答本身,也在积累。

问的不只是文档,是全部积累编织出的答案。
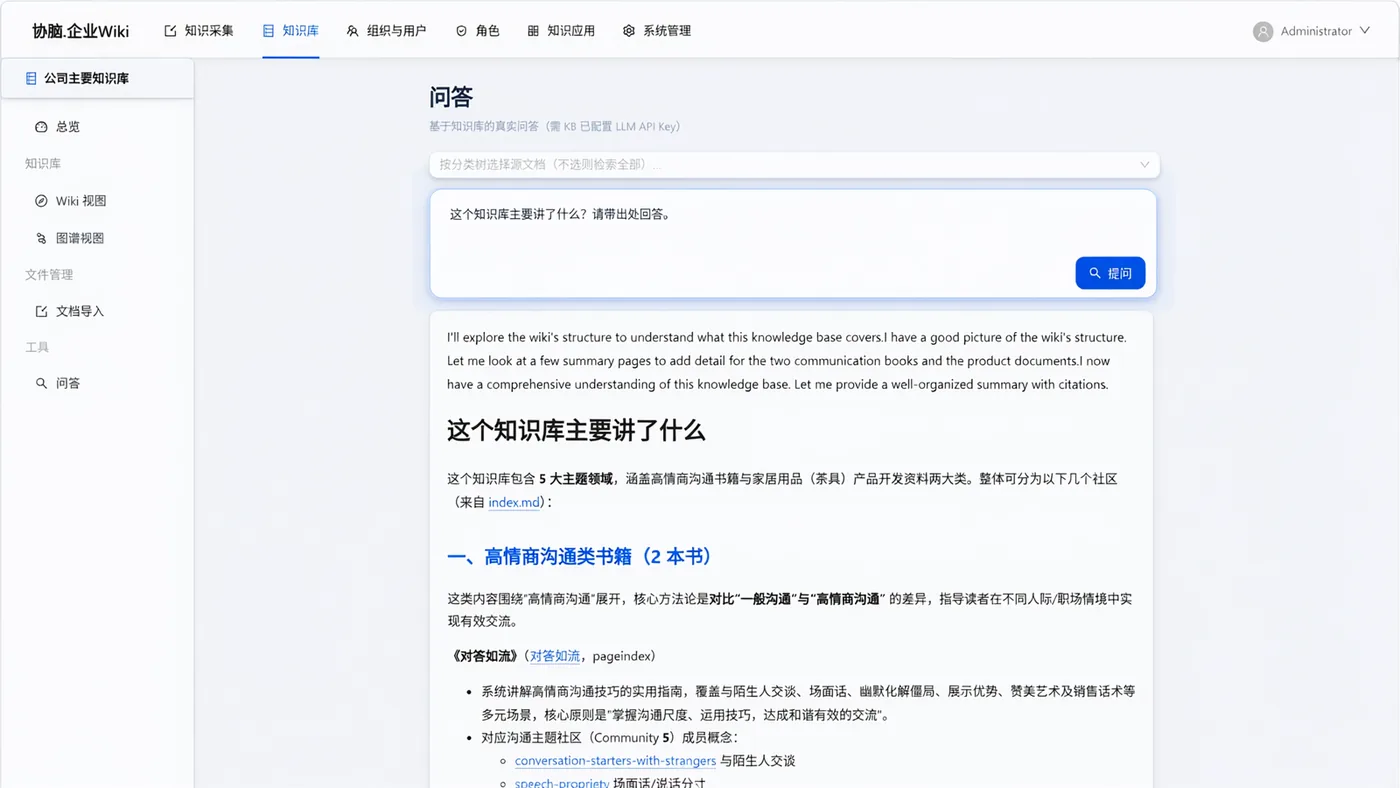
智能问答全视图 · 产品实拍
智能问答全视图 · 产品实拍
华东区 Q4 毛利率为什么下滑?
主要受交付延期与折扣加深影响;相关依据来自经营月报与项目复盘。[1][2]
如果只看老客户续费呢?
老客户续费毛利率保持 68%,下滑主要来自两个新签项目的首期交付成本。[3]
答案回流 · 问答也在积累 提问→多轮推理→引用原文→存回 Wiki

三个最实在的顾虑,各有一道闸门接住。

AI 的答案,敢用才算数

顾虑一「AI 会编。」
闸门 · 回源——每一个结论都被强制回到原文核对,答案自带引用出处:溯源不是附加功能,是默认姿势。
顾虑二「数据给出去,不放心。」
闸门 · 私有化 + Markdown + 文档级权限——部署在你自己的服务器上,数据不出你的门;知识本体是透明的 Markdown,哪天你不用协脑了,知识一页不少地带走。对内,权限细到一份文件、一个段落(详见优势十)。
顾虑三「买回去,没人用。」
闸门 · 它是问答入口——员工不需要学任何「知识管理方法论」:把文档放进去,像问同事一样提问;知识在后台自动编译、自动生长。

顾虑被接住了,信任才有地方长。

没有漫长的实施项目,没有前置咨询费。

从一个部门、一批文档开始

第 1 周
选一个最痛的部门

通常是客服、交付或研发;批量导入制度、方案、复盘、FAQ。也可从全员制度库开始。

第 2 周
用问答入口工作

每个答案都可点开看出处。信任是长出来的,不是要求出来的。

第 1 个月起
按部门扩展

各部门各自建库、权限隔离;知识随日常文档持续积累,不需要专人维护。

见效周期以周计,不以年计。

知识复利曲线(概念示意)
每一次问答的质量起点 知识库的文档积累量 → 协脑 · 答案随积累越来越准 传统检索 · 每次从零

概念示意,非实测数据;横轴为文档积累量,纵轴为问答质量起点,均无绝对刻度。

文档越积越多,答案越问越准——这就是知识复利。

全部核心自研。

这套产品,是我们 agent 能力的实证

关于我们:组织的智慧,不该依赖个人的记忆——协脑.企业Wiki 只做两件事,并把这两件事做透:把文档编译成持续生长的知识 Wiki,让每一次问答都站在全部积累之上。
问答 agent多轮推理、强制回源 无向量树索引沿文档结构推理定位 社区层自动发现跨文档主题 编译流水线入库自动摘要、抽概念、织引用
定制邀约:如果你的组织有超出标准产品的智能化需求——基于自有数据的 agent、行业知识引擎、定制问答入口——我们用同一套技术为你构建。
协脑.企业Wiki 微信二维码
微信扫码 · 体验演示环境预约 30 分钟远程演示 · 请带上最想问的三个问题
电话:13950065406 | 联系人:李经理

知识复利,从第一份文档开始。

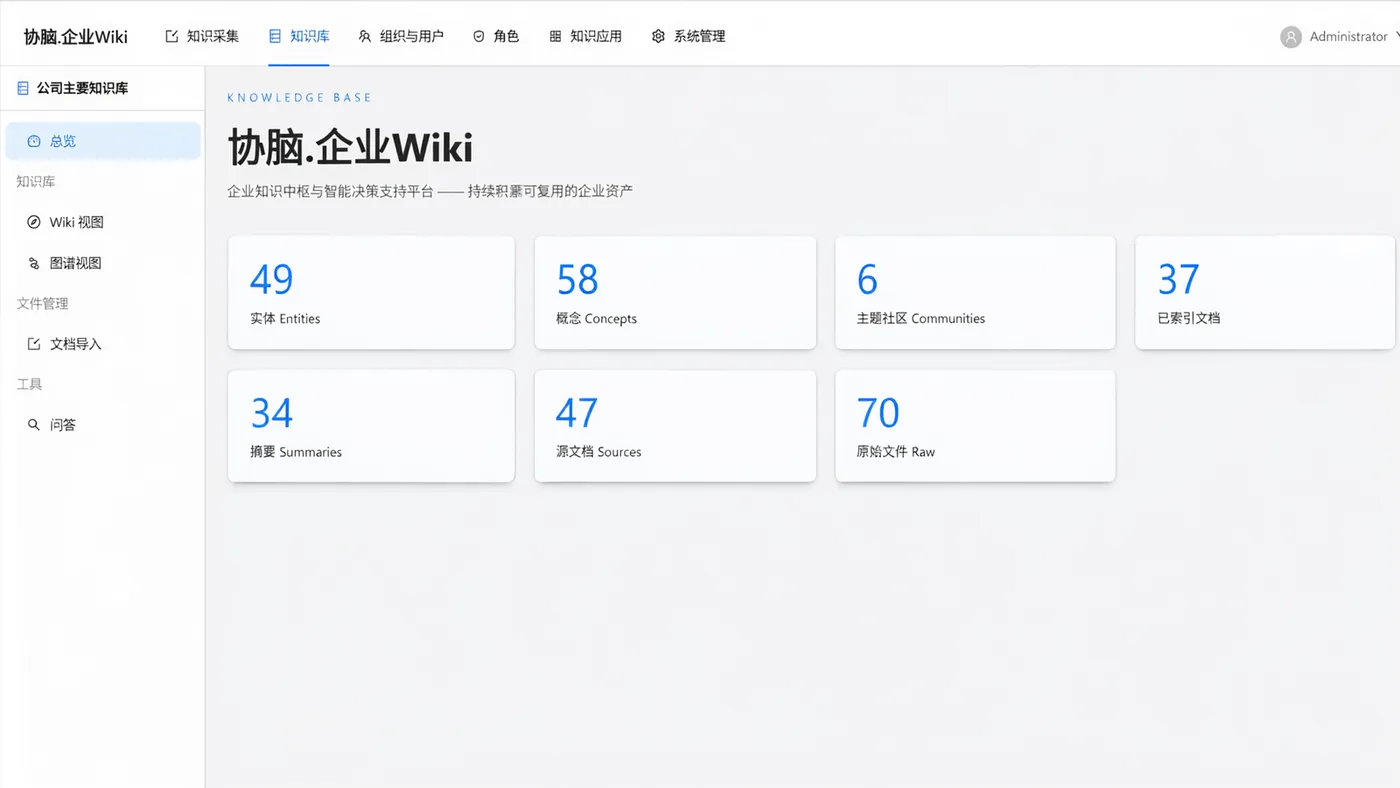
运行中的管理仪表盘 · 产品实拍
管理仪表盘 · 产品实拍

协脑.企业Wiki